¿Qué sobrevive a una lectura equivocada?

El solver como verificador de la percepción en KenKen desde imagen

Rody Vilchez · José Villanueva · Jorge Garcia

Grupo 3 · Tópicos en Ciencias de la Computación · UPC

9 de octubre de 2026

01 · El problema Resolver un KenKen desde una foto

Son dos tareas distintas que fallan de forma distinta: percibir el tablero y razonar sobre él.
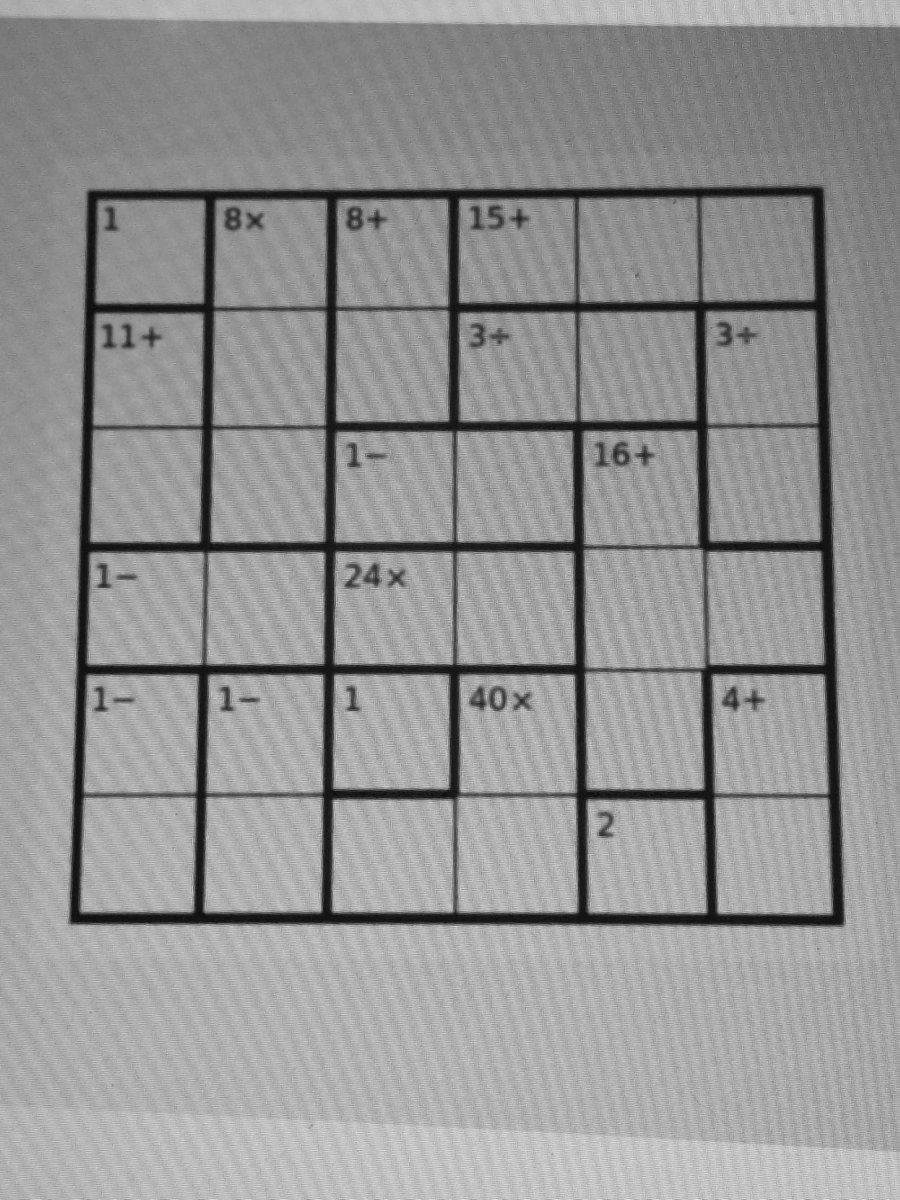
Foto real de un KenKen de 6×6 tomada con el celular a una pantalla

Foto real, tomada con el celular a una pantalla.

Percibir

Tamaño, jaulas y etiquetas. Falla como falla una foto: luz, perspectiva, un ÷ que parece +.

Razonar

Un modelo de restricciones en CP-SAT. Exacto sobre la instancia que recibe.


Si la visión lee un 5 donde hay un 6, el solver resuelve con exactitud el puzzle equivocado.

¿Qué sobrevive a una lectura equivocada?

01 · El problema Los errores pequeños se acumulan

Leer bien el 97% de las etiquetas significa acertar unos 7 de cada 10 tableros completos.

KenKen: 97.09% por etiqueta (este trabajo)Sudoku: 99% por celda (Mulamba et al., 2024)
  1. Si los errores fueran independientes, un tablero con k etiquetas sale entero con pk.
  2. Lo medido en 70 tableros reales sigue la curva: 48 de 70 salen enteros.Los 9×9 tienen ~30 etiquetas y aciertan 3 de 7.
  3. El sudoku lo confirma: 99% por celda es 44% por tablero.
  4. No basta con leer mejor. Hay que verificar lo leído.

02 · Arquitectura Cómo está armado el sistema

La visión y el solver solo se comunican a través de la instancia.

1 · La app toma la foto y la envía en JSON. adb reverse la lleva por USB o Wi-Fi a la PC, sin abrir puertos.

2 · El nodo de cómputo (FastAPI) atiende POST /resolver en el puerto 8723.

3 · La Fase 1 reconstruye el tablero sin aprendizaje: tamaño, jaulas y etiquetas.

4 · La instancia es el contrato: lo único que la Fase 2 llega a ver.

5 · CP-SAT resuelve y cuenta soluciones, con tope de dos.

6 · Con una, se devuelve. Con ninguna, el solver intenta reparar la lectura. Con varias, se rechaza.

7 · La respuesta vuelve a la app: estado, solución, correcciones y dónde cae cada celda en la foto.

03 · Fase 1: visión Encontrar y enderezar el tablero

Umbral, contorno y homografía. Todo lo que sigue trabaja sobre la imagen enderezada.
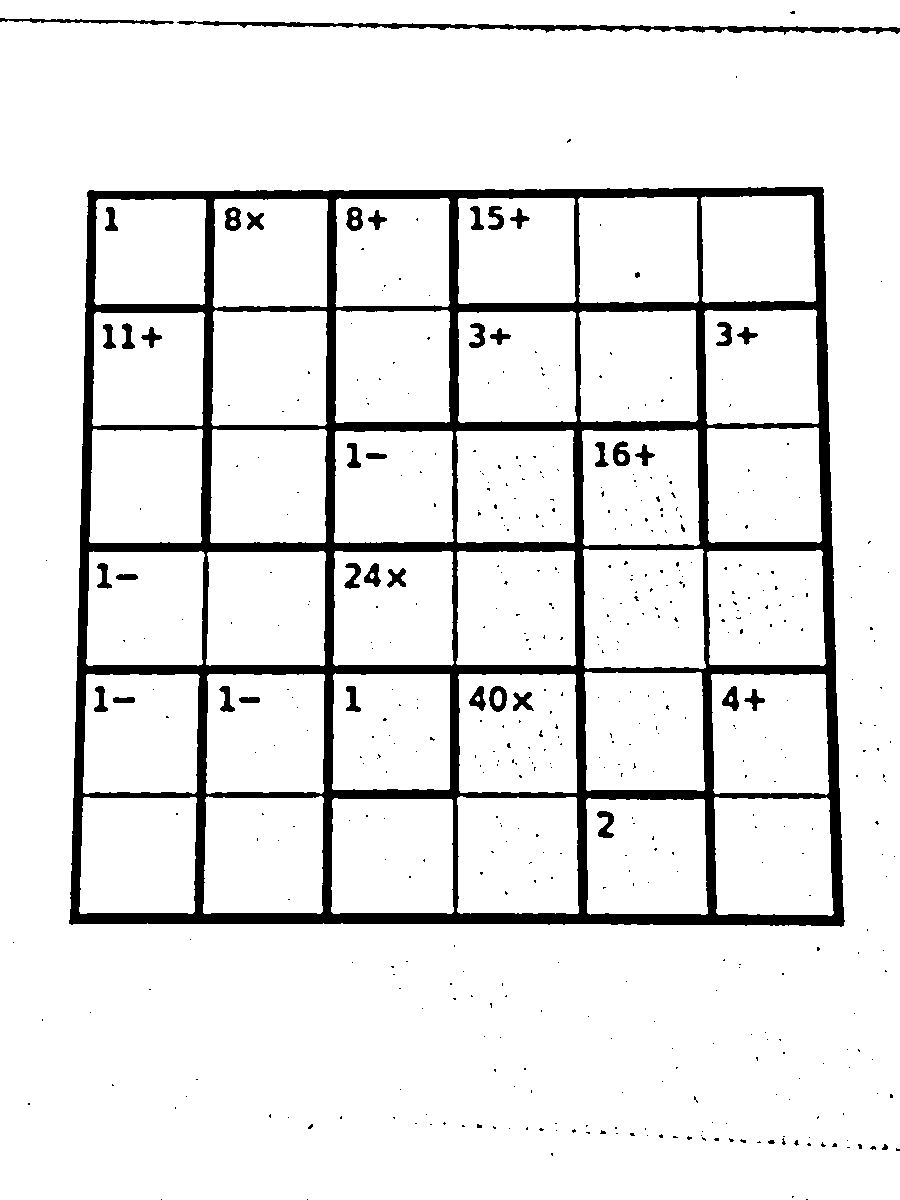
Foto original Foto binarizada con umbral adaptativo

Tablero rectificado a 900 por 900 píxeles

  1. Umbral adaptativo. La tinta queda separada aunque la luz no sea pareja.
  2. El contorno externo mayor se aproxima por un cuadrilátero: cuatro esquinas.
  3. Homografía. Las esquinas enderezan el tablero a 900 × 900 px.
  4. Todo lo demás trabaja sobre esa imagen, nunca sobre la foto.

03 · Fase 1: visión Detectar el tamaño del tablero

Se prueba cada n posible: el correcto es el mayor cuyas líneas existen todas.

  1. Perfil de tinta de los trazos verticales largos, columna por columna.
  2. Con n = 4 se predicen líneas donde no hay tinta: la más débil queda en cero.
  3. Con n = 6 todas las líneas predichas existen.
  4. n = 3 también pasa: es divisor. Se elige el mayor n con todas sus líneas.

Toca cualquier n para probarlo.

03 · Fase 1: visión Separar las jaulas

Los bordes de jaula se imprimen más gruesos: basta medir el grosor de cada arista.

Tablero rectificado

  1. Mediana del ancho del trazo en cada una de las 60 aristas interiores.
  2. Dos anchos de pluma: la distribución es bimodal y Otsu la corta sola.
  3. Gruesa = borde de jaula. Unión-búsqueda junta el resto: 17 jaulas.

03 · Fase 1: visión Leer las etiquetas

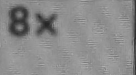
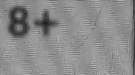
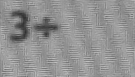
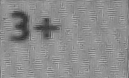
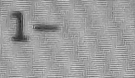
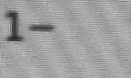
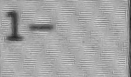
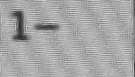
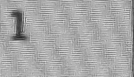
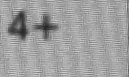
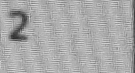
Los 17 recortes reales de la foto, con lo que leyó la visión debajo de cada uno.
1
8×
8+
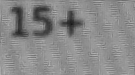
15+
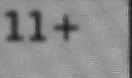
11+
3+
3+
1−
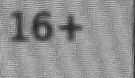
16+
1−
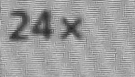
24×
1−
1−
1
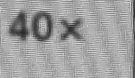
40×
4+
2

Aquí, los puntos del ÷ se fundieron con la barra y la visión leyó 3+ dos veces. La instancia sigue siendo válida: nada en la Fase 1 puede saberlo.

03 · Fase 1: visión Cómo leemos una etiqueta: plantillas

Cada carácter se compara con plantillas dibujadas en 7 tipografías, y gana la más parecida.

  1. Recorte de la esquina de la celda, donde se imprime la etiqueta.
  2. Una mancha de tinta, un carácter. El ÷ son tres manchas y se reagrupan; aquí los puntos se fundieron con la barra.
  3. Normalizar cada carácter a 28 × 28 píxeles, sin deformarlo.
  4. Comparar con la plantilla de cada carácter por correlación normalizada: 1 es idéntico.
  5. Gana el más parecido. El + le ganó al ÷ por un centésimo: leímos 3+.

04 · Fase 2: solver El modelo de restricciones

Un modelo genérico en CP-SAT: sirve para cualquier tamaño y cualquier tablero.

def construir_modelo(inst):
    n, m = inst.size, cp_model.CpModel()
    x = [[m.NewIntVar(1, n, f"x{r}{c}") for c in range(n)]
         for r in range(n)]
    # cuadrado latino: 2n restricciones globales
    for i in range(n):
        m.AddAllDifferent(x[i])
        m.AddAllDifferent([x[j][i] for j in range(n)])
    # una restricción por jaula
    for k, jaula in enumerate(inst.cages):
        v, T = [x[r][c] for r, c in jaula.cells], jaula.target
        if jaula.op == "=":   m.Add(v[0] == T)
        elif jaula.op == "+": m.Add(sum(v) == T)
        elif jaula.op == "*": m.AddMultiplicationEquality(T, v)
        else:  # − y ÷: el orden de las celdas no importa
            M = m.NewIntVar(1, n, f"M{k}")
            mi = m.NewIntVar(1, n, f"m{k}")
            m.AddMaxEquality(M, v)
            m.AddMinEquality(mi, v)
            m.Add(M - mi == T if jaula.op == "-" else M == T * mi)
    return m, x

kenken_cp/solver.py, condensado. Lo escribió el equipo, sin asistencia de IA.

\(x_{i,j} \in \{1,\dots,n\}\)

AllDifferent por fila y columna: \(2n\) restricciones globales.

Jaulas: \(=\), \(\sum\), \(\prod\) y, para \(-\) y \(\div\), el par \(\max/\min\): simétrico y sin booleanos.

El modelo es \(O(n^2)\), pero completar un cuadrado latino ya es NP-completo. En la práctica, la propagación basta: ningún tablero real ramifica.

04 · Fase 2: solver El solver también verifica la lectura

Un puzzle publicado tiene una sola solución. Contarlas dice si lo que leyó la visión es confiable.

1

Una solución

La lectura es consistente. Se devuelve.

0

Ninguna

El solver demuestra que algo se leyó mal. Se intenta reparar.

≥ 2

Varias

La lectura no basta para decidir. Se rechaza, en llano.


contar_soluciones(instancia, tope=2)   # enumerate_all_solutions + StopSearch al llegar a 2

04 · Fase 2: solver Reparar una lectura equivocada

Si no hay solución, el solver prueba lecturas parecidas hasta dar con la única que funciona.

for k, (jaula, cands) in enumerate(zip(inst.cages, opciones)):
    lits = []  # cands: lo leído (peso 0) y alternativas
    for j, (op, t, w) in enumerate(cands):
        ell = m.NewBoolVar(f"l{k}_{j}")
        if   op == "+": m.Add(suma == t).OnlyEnforceIf(ell)
        elif op == "*": m.Add(prod == t).OnlyEnforceIf(ell)
        elif op == "-": m.Add(M - mi == t).OnlyEnforceIf(ell)
        elif op == "/": m.Add(M == t * mi).OnlyEnforceIf(ell)
        lits.append(ell)
        if j > 0:  # primero cambios; luego, plausibilidad
            cambios.append(ell)
            peso.append((100 + w) * ell)
    m.AddExactlyOne(lits)

m.Add(sum(cambios) <= max_cambios)
m.Minimize(sum(peso))

kenken_cp/reparar.py, condensado.

\[\ell_{k,c} \Rightarrow \textit{jaula}_k(c) \qquad \textstyle\sum_c \ell_{k,c} = 1\]

  1. Candidatas a un glifo: ÷ ↔︎ +, 5 ↔︎ 6… con el peso de lo que observamos fallar.
  2. Un literal por candidata y exactamente una por jaula.
  3. Mínimo de cambios; a igual número, la más plausible.
  4. Se acepta solo si ninguna otra corrección con un cambio más lleva a otro tablero y la solución es única.

04 · Fase 2: solver Un ejemplo real de reparación

La visión leyó dos 3÷ como 3+. El solver lo detectó y lo corrigió.

Foto real del tablero

  1. La visión lee 17 jaulas y la instancia cumple el contrato.
  2. Dos dicen 3+. En el papel dicen 3÷.
  3. CP-SAT demuestra que no tiene solución, sin ramificar.
  4. Prueba las candidatas de cada jaula: solo una corrección cierra el tablero.
  5. Solución única, dibujada sobre la propia foto con la homografía inversa.

05 · Evaluación Con qué datos evaluamos

Tableros reales de KrazyDad, con la respuesta correcta sacada del propio PDF.

72

tableros reales de KrazyDad: 48 de 4×4, 16 de 6×6 y 8 de 9×9

895

etiquetas, cada una con su verdad exacta

5

cuadernillos: dos para desarrollar, tres que nadie miró

0

etiquetas puestas a mano


Los PDF son vectoriales: cada etiqueta está como texto con su caja. Proyectada con la homografía del tablero, da su celda. La celda sale de la geometría, no del detector, así que el detector no se mide contra sí mismo.

KrazyDad autoriza el uso escolar y prohíbe el comercial. Los PDF se descargan bajo demanda y no se redistribuyen.

05 · Evaluación Qué tan bien leemos las etiquetas

Acertamos el 97% de 895 etiquetas, y 4 de cada 5 errores son el mismo: un 5 leído como 6.

bien leídaun 5 leído como 6otro fallo (3 ilegibles de cuatro cifras, 6×→8×, 288×→286×)

97.09% de 895 etiquetas, κ de Cohen 0.969: «casi perfecto».

En los cuadernillos que nadie miró, 96.45% (p = 0.24 frente a desarrollo). Pero el fallo cambia: 16 de sus 17 errores son 5+ → 6+.

05 · Evaluación Resultado con los 70 tableros

Ningún tablero mal leído terminó en una solución equivocada.

bien leídosin soluciónreparadorechazado o abstención
  1. 70 tableros con verdad, de 4×4 a 9×9.
  2. 48 se leen bien de punta a punta.
  3. De los 22 mal leídos, 3 se rechazan antes del solver y en 19 el solver demuestra que no hay solución.
  4. La reparación recupera 16 de 19 y se abstiene en 3.
  5. Cero soluciones erróneas.

05 · Evaluación Cuándo aceptar una corrección

Solo si ninguna otra corrección parecida lleva a otro tablero. Prueba los parámetros.

Las 19 lecturas reales sin solución, reparadas con distintos parámetros.

La primera versión aceptaba la corrección mínima si era única de su tamaño (margen 0). En un 4×4 con dos 5+ leídos como 6+, arreglar uno solo ya cerraba el tablero, pero con otra solución.

Ahora se exige que ninguna corrección con un cambio más lleve a otro tablero. Si dos explicaciones son casi igual de plausibles, el nodo se abstiene.

05 · Evaluación Por qué usar AllDifferent

Con restricciones globales, ningún tablero real necesita búsqueda.

AllDifferent (este trabajo)desigualdades binarias x ≠ y
  1. Con AllDifferent, la propagación en la raíz fija las n² celdas en los 70 tableros. Ni una rama.
  2. Con x ≠ y el modelo dice lo mismo pero propaga menos: 6 de 7 tableros de 9×9 buscan, hasta 5 883 ramas.

9×9, mediana: 7.7 ms → 81.9 ms. Diez veces más.

Las 19 lecturas sin solución también se refutan sin ramificar.

05 · Evaluación Datos sintéticos frente a reales

Sirvieron para desarrollar, pero hacen creer que leemos mejor de lo que leemos.

  1. Sintéticos: verdad gratis y condiciones de foto. Guiaron el diseño.
  2. Reales: 48 de 70. Por debajo de todos.

El pipeline falló en los 16 primeros tableros reales: la rejilla se interrumpe, la tinta no cae en el píxel predicho, un margen fijo cortaba los dígitos y KrazyDad imprime glifos que el banco no tenía.

06 · La app La app en el celular

Muestra lo que decidió el solver, incluida la corrección.
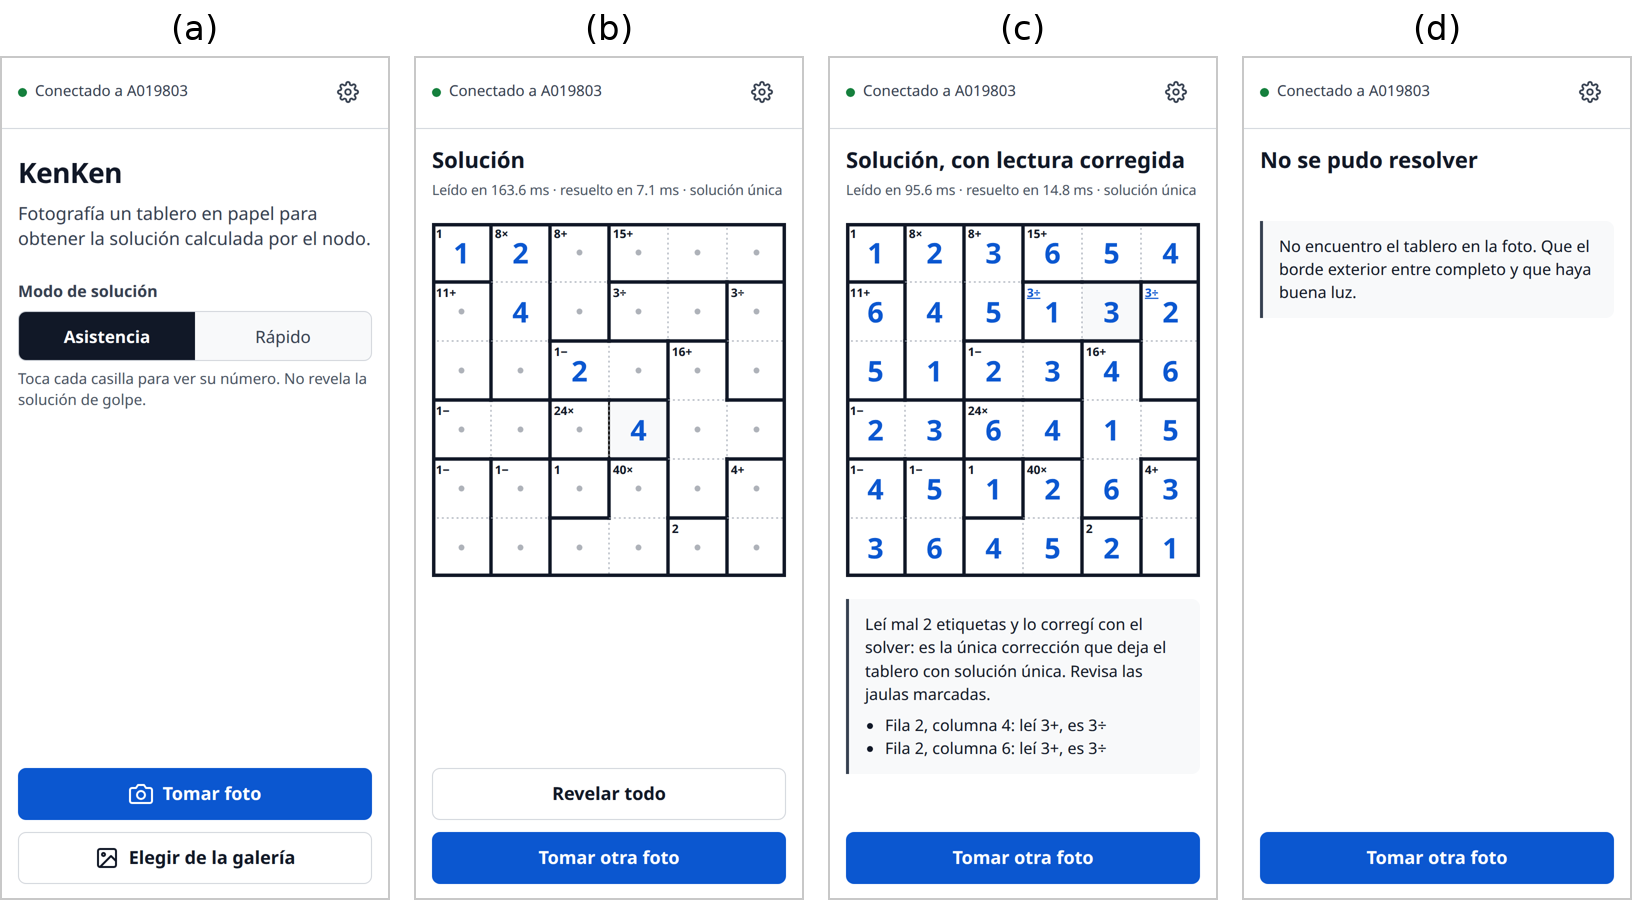
Cuatro pantallas de la app: inicio, modo asistencia, una lectura reparada y una foto sin tablero
  1. (a) Inicio: estado del nodo y modo.
  2. (b) Asistencia, por defecto: el tablero sin números; revelas solo la casilla que tocas.
  3. (c) Reparado: la app lo dice y marca las jaulas corregidas.
  4. (d) Sin tablero: lo dice en llano y pide otra foto.

06 · La app Demo en vivo

  1. Foto con el Pixel, a un KenKen impreso o en pantalla.
  2. Nodo en la laptop: uv run python -m kenken_nodo
  3. Conexión: adb reverse tcp:8723 tcp:8723
  4. Modo Rápido → «Sobre tu foto».


Leerlo y resolverlo tomó 111 ms.
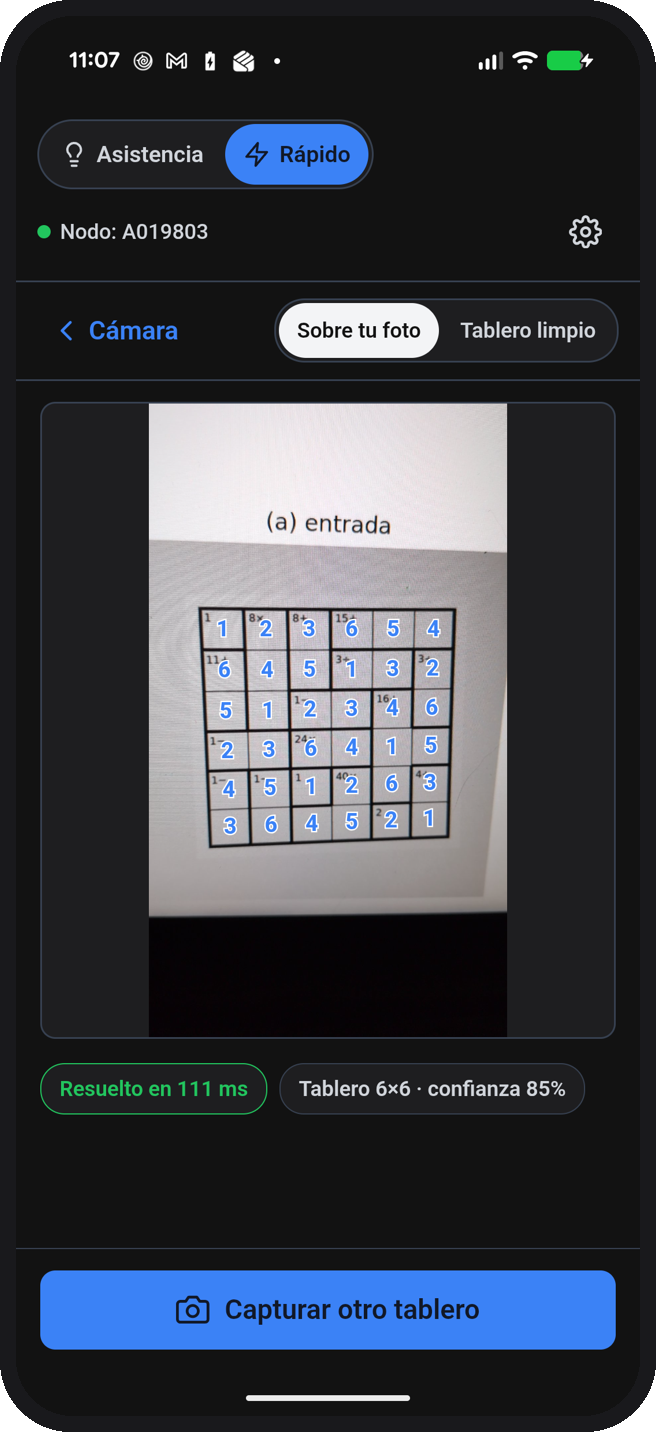
Captura del Pixel 9a con la solución dibujada sobre la foto

06 · La app Demo grabada

Respaldo por si falla la demo en vivo: 1 min 27 s. Toca un capítulo para saltar.

  1. Una lectura sin solución única: la app lo dice y pide otra foto.
  2. Modo Rápido: foto a un 5×5 en la pantalla y la solución sobre la foto, en 59 ms.
  3. Modo Asistencia: el mismo tablero, sin números.
  4. Otra foto: el nodo la lee y la resuelve en 60 ms.
  5. Sobre tu foto y tablero limpio.
  6. Asistencia: revelar casilla por casilla y «¿Voy bien?».

07 · Cierre Conclusiones

La visión clásica lee bien

97.09% de 895 etiquetas sin aprendizaje. Su error se concentra en un par de glifos.

El solver verifica y repara

Contar soluciones frenó los 22 tableros mal leídos. La reificación reparó 16 de 19. Cero errores silenciosos.

Lo sintético no basta

Sirvió para construir. Las cifras que valen son las de tableros reales que nadie miró.


El solver no solo resuelve el puzzle: es el control de calidad de lo que la visión cree haber leído.

¿Preguntas?

Rody Vilchez · José Villanueva · Jorge Garcia


Código: github.com/R0SEWT/cs-topics, en labs/tb1-kenken

Informe y fotos: release TB1 - KenKen

Estas diapositivas: kenken.rosewt.dev

Dataset de fotos: huggingface.co/datasets/rosewt/kenken-tb1-fotos


Usamos IA generativa (Claude Code) en el andamiaje de la visión, los scripts de medición, el informe y estas diapositivas. El modelo de CP lo escribió el equipo. Todas las cifras salen de scripts del repositorio y el equipo las revisó.
Código QR al release TB1 en GitHub

Release con el informe en PDF

Apéndice Limitaciones

  1. Los 70 tableros son de un solo editor y una tipografía (Helvetica; el banco tiene un clon). No miden tipografías desconocidas.
  2. Son PDF rasterizados: tinta real, sin sombras, curvatura ni desenfoque. Lo fotográfico solo lo cubre el sintético.
  3. Cero soluciones erróneas es un resultado sobre 22 tableros mal leídos, no una garantía: una lectura equivocada que deje otro puzzle válido y único pasaría.
  4. Las etiquetas de cuatro cifras que desbordan su celda se rechazan antes del solver.
  5. Las 16 reparaciones son sobre 19 tableros de un editor. Falta reparar ilegibles, lecturas con varias soluciones y ponderar con la confianza del clasificador (inferencia conjunta, Mulamba et al.).

Apéndice Comparación con otros OCR

Exactitud (%) sobre las 412 etiquetas del conjunto de desarrollo. «Plantillas» es nuestro método: correlación normalizada contra los caracteres dibujados en 7 tipografías.

Método Etiqueta Operación Número
Plantillas (este trabajo) 98.8 99.3 98.8
Tesseract 5.3.4 97.1 97.8 97.8
RapidOCR (PP-OCR) 64.8 68.4 94.2
TrOCR base printed 60.9 63.6 95.1

«Etiqueta» exige número y operación correctos; «Operación» y «Número» miden cada parte por separado.

Plantillas frente a Tesseract: discrepan en 11 etiquetas, 9 a favor de las plantillas (McNemar, p = 0.065). Al menos uno de los dos acierta 411 de 412. Es una cota optimista: se midió sobre el conjunto con que se ajustaron las plantillas.

Apéndice Tiempo del solver

resolver sobre la verdad de los 70 tableros (ms): el solver no es el cuello de botella.

n Tableros Mediana Máximo
4 47 4.4 7.8
6 16 4.1 5.1
9 7 10.8 14.1

Sobre lo que el sistema lee, incluidas las instancias sin solución, el máximo es 20.4 ms. Intel Core Ultra 7 255U, OR-Tools 9.15, Python 3.13. La reparación tarda menos de 200 ms por tablero.